Role umělé inteligence v identifikaci nových léčiv
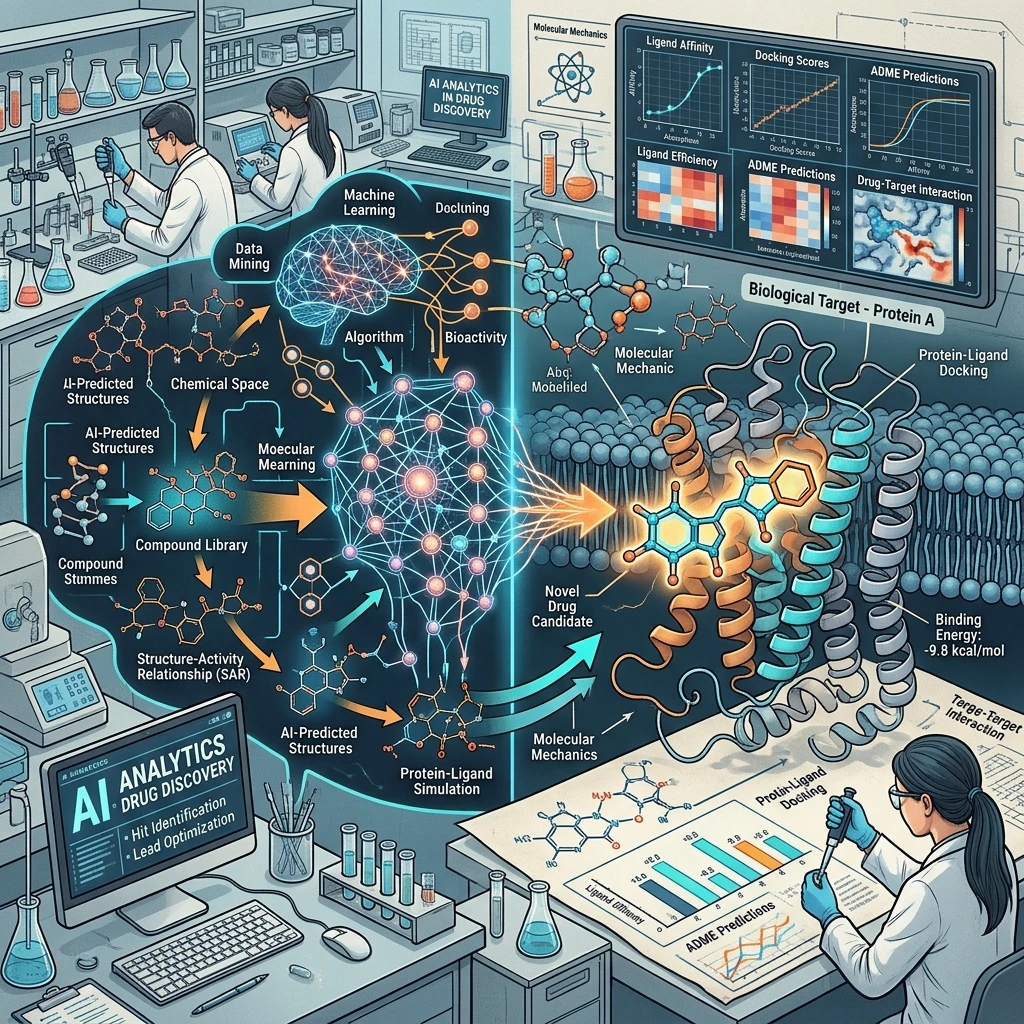
Umělá inteligence pomáhá výzkumníkům rychleji procházet biologická a chemická data, vybírat slibné kandidátní molekuly a plánovat jejich ověření. Nejde však o automatickou výrobu hotového léku: výpočetní předpovědi musí potvrdit laboratorní experimenty a následně také klinické studie.
Jak probíhá objevování léčiv
Objevování léčiv začíná hledáním biologického cíle a pokračuje výběrem molekul, které by ho mohly ovlivnit. Kandidáti pak procházejí laboratorním ověřením, předklinickým výzkumem a klinickými studiemi, než lze posoudit jejich přínos pro pacienty.
Biologickým cílem bývá například protein, receptor nebo enzym spojený s průběhem onemocnění. Vědci nejprve zkoumají, zda jeho ovlivnění může mít žádoucí účinek a zda je cíl dostatečně dobře pochopený. Teprve potom hledají látky, které s ním dokážou vhodně interagovat.
V rané fázi se používá screening léčiv: testují se známé nebo nově navržené molekuly, aby se našly takzvané zásahové látky. Ty se dále upravují a porovnávají podle účinnosti, selektivity a dalších vlastností. Molekula, která působí na cíl v laboratorním testu, totiž nemusí být vhodná jako lék. Může se špatně vstřebávat, rychle se rozkládat nebo mít nežádoucí účinky.
Následuje předklinický výzkum, který hodnotí biologické působení a bezpečnost pomocí laboratorních metod a podle potřeby také studií na zvířatech. Pokud výsledky a regulační požadavky umožní pokračovat, kandidát vstupuje do klinických studií. Ty postupně zkoumají bezpečnost a účinnost u lidí. Každý krok tak filtruje jiné riziko; výpočetní objevování léčiv může pomoci s výběrem, ale žádnou z těchto ověřovacích fází samo nenahrazuje.
Jak AI pomáhá vyhledávat a hodnotit kandidáty
AI dokáže roztřídit velké soubory molekul a odhadnout, které stojí za další testování. Strojové učení hledá v biologických a chemických datech vzorce, které mohou člověku uniknout, výsledkem je však pořadí kandidátů, nikoli důkaz jejich léčebné účinnosti.
Při virtuálním screeningu modely porovnávají molekulární struktury s informacemi o biologickém cíli. Jedním z používaných výpočetních postupů je molekulární docking, který odhaduje, jak by se molekula mohla navázat do vazebného místa proteinu. Výsledek může pomoci vybrat látky pro experimentální testy, ale závisí mimo jiné na kvalitě struktury cíle a na zjednodušeních výpočtu.
Další skupinou nástrojů je predikce vlastností molekul. Modely mohou odhadovat například rozpustnost, průchod biologickými membránami, stabilitu nebo riziko toxicity. Tyto vlastnosti pomáhají odhalit praktické problémy dříve, než tým investuje čas do náročnějších experimentů. Odhady ale nejsou rovnocenné měření: nepřesnost může vzniknout, když se nová molekula výrazně liší od příkladů, na kterých se model učil.
Výzkumníci proto často kombinují více metod a výsledky posuzují podle účelu. Molekula s příznivým dockingovým skóre může být špatně rozpustná; látka s dobrými farmakologickými vlastnostmi zase nemusí dostatečně ovlivňovat zvolený cíl. Vhodný kandidát musí obstát v několika nezávislých kontrolách.
Návrh nových molekul pomocí AI
Generativní modely navrhují nové molekulární struktury podle zadaných cílů a omezení. Mohou urychlit hledání variant, které by chemici jinak vytvářeli postupně, ale každý návrh je nutné zkontrolovat z hlediska účinku, bezpečnosti i možnosti skutečné syntézy.
Model se učí z chemických struktur a jejich známých vlastností. Poté může navrhovat molekuly, které mají například lépe zapadat do vazebného místa, vykazovat určitou rozpustnost nebo se vyhnout vybraným nežádoucím znakům. Některé přístupy upravují existující látku, jiné vytvářejí kandidáty od základu.
V praxi návrh obvykle probíhá v cyklu: model vytvoří návrhy, výpočetní metody je předběžně vyhodnotí a chemici vyberou ty, které lze rozumně připravit. Laboratoř pak ověří, zda se látka skutečně syntetizuje a zda její biologické působení odpovídá předpokladům. Naměřené výsledky se mohou vrátit do modelu a pomoci zpřesnit další výběr.
Klíčové je nepovažovat matematicky příznivé skóre za známku dobrého léčiva. Molekula může splnit řadu výpočetních kritérií a přesto selhat kvůli nestabilitě, nežádoucím účinkům nebo složité výrobě. Generativní AI tedy rozšiřuje prostor možností; biologická a chemická odbornost rozhoduje, které návrhy stojí za ověření.
Jaká data a metody AI potřebuje
Modely AI potřebují kvalitní biologická, chemická a experimentální data, která odpovídají otázce, již mají řešit. Čím lépe data zachycují skutečné podmínky měření a jejich nejistotu, tím užitečnější mohou být výstupy pro výzkumný tým.
Chemická data zahrnují struktury molekul a jejich naměřené vlastnosti. Biologická data mohou popisovat proteiny, genetické informace nebo buněčné procesy. Experimentální záznamy pak ukazují, jak konkrétní látky působily v určitém testu. Význam mají také informace o použité metodě, koncentraci, prostředí a biologickém systému, protože výsledky z různých experimentů nemusí být přímo srovnatelné.
Pokud jsou záznamy chybné, neúplné nebo si odporují, model může převzít jejich zkreslení. Podobně hrozí, že se při hodnocení nástroje omylem použijí molekuly, které se už objevily v trénovacích datech; výkon pak vypadá lépe, než jaký bude u dosud neznámých látek. Týmy proto potřebují kontrolovat původ dat, sjednocovat zápisy a testovat modely na nezávislých souborech.
Důležitá je i oblast použití. Model natrénovaný na jednom typu testu nemusí spolehlivě předpovídat výsledky jiného testu nebo účinek v lidském organismu. Výzkumníci by proto měli znát rozsah dat, na kterých model funguje, a zaznamenávat také nejistotu predikce. Číslo bez kontextu může působit přesněji, než ve skutečnosti je.
Přínosy a omezení AI ve výzkumu léčiv
AI může zrychlit třídění kandidátů, pomoci spojovat různorodá data a zacílit laboratorní práci na molekuly s větším potenciálem. Její omezení spočívá v tom, že model pouze odhaduje na základě dostupných dat a předpokladů; experimentální důkaz ani klinický výsledek tím nevzniká.
Vhodně zavedené výpočetní metody mohou omezit počet látek, které tým testuje jako první, nebo upozornit na nežádoucí vlastnosti ještě před syntézou. Časová a finanční úspora ale závisí na konkrétním projektu, kvalitě dat a návaznosti laboratoře. Samotné nasazení modelu nezaručuje rychlejší vývoj ani úspěšnější kandidáty.
Častou chybou je zaměňovat predikci za experimentální výsledek. Model může předpovědět vazbu na protein, ale neprokazuje, že se vazba skutečně projeví v živé buňce. Řešením je ověřovat odhady vhodně zvolenými laboratorními testy.
Druhým rizikem je přílišná důvěra v jediné skóre. Různé modely hodnotí různé aspekty molekuly a jejich výsledky mohou být v rozporu. Tým by měl sledovat více relevantních vlastností, porovnávat metody a kontrolovat nejistotu. Ani příznivé předklinické výsledky navíc nezaručují úspěch v klinických studiích, kde se účinek i bezpečnost zkoumají u lidí.
AI má tedy největší přínos jako nástroj pro prioritizaci a formulování hypotéz. Její výstupy mohou ukázat, co testovat dál, nikoli nahradit rozhodování o tom, zda je molekula bezpečná a účinná.
AI jako součást výzkumného týmu
AI funguje nejlépe jako součást týmu, v němž biologové, chemici, lékaři a výpočetní odborníci společně interpretují výsledky. Model může navrhnout, kam zaměřit pozornost; odborníci určují, zda jeho předpoklady odpovídají biologii, chemii a klinickému problému.
Praktická spolupráce začíná jasnou výzkumnou otázkou. Biologové pomáhají vybrat vhodný cíl a vysvětlit jeho roli v nemoci. Chemici posuzují, zda lze navržené molekuly připravit a smysluplně upravit. Výpočetní specialisté vybírají metody, kontrolují kvalitu dat a vysvětlují nejistotu výsledků. Lékaři přidávají pohled na klinickou potřebu a na to, jaký typ léčebného přínosu by měl výzkum sledovat.
Užitečný pracovní postup propojuje výpočty s experimenty v několika kolech: tým vybere kandidáty, laboratoř změří jejich vlastnosti a výsledky se použijí při dalším rozhodování. Taková spolupráce pomáhá odhalit i chybný předpoklad modelu, například když se předpokládané navázání vyskytuje jen v počítačovém modelu, nikoli v testu.
Výsledkem není odstranění nejistoty, ale její lepší řízení. AI může pomoci výzkumníkům rozhodovat, které otázky položit a které molekuly prověřit jako první; odpovědi musí dál vycházet z reprodukovatelných experimentů a pečlivého hodnocení.
Časté otázky
Nahrazuje AI laboratorní výzkum?
Ne. AI může navrhovat kandidáty a pomáhat s jejich prioritizací, ale laboratorní experimenty ověřují, zda molekula skutečně působí podle předpovědi. Předklinické testování a klinické studie mají vlastní úkoly, které výpočetní model nenahradí.
V jaké fázi vývoje léčiva může AI pomoci?
AI se uplatní při hledání biologických cílů, screeningu léčiv, molekulárním dockingu, predikci vlastností i návrhu nových molekul. Může také pomáhat při analýze dat v pozdějších fázích. Konkrétní přínos závisí na dostupných datech a výzkumné otázce.
Proč je kvalita dat pro modely AI důležitá?
Model se učí z příkladů, které dostane. Chybná, neúplná nebo špatně srovnatelná biologická a chemická data mohou vést k zavádějícím předpovědím. Kvalitní data a nezávislé testování pomáhají lépe posoudit, kde lze modelu důvěřovat.
Zaručí predikce AI, že bude molekula účinná a bezpečná?
Ne. Predikce vyjadřuje odhad, nikoli záruku účinnosti nebo bezpečnosti. Molekula musí projít experimentálním ověřením, předklinickým výzkumem a klinickými studiemi, než lze její použití u lidí odpovědně posoudit.