Výpočetní metody pro predikci vazebných míst léčiv
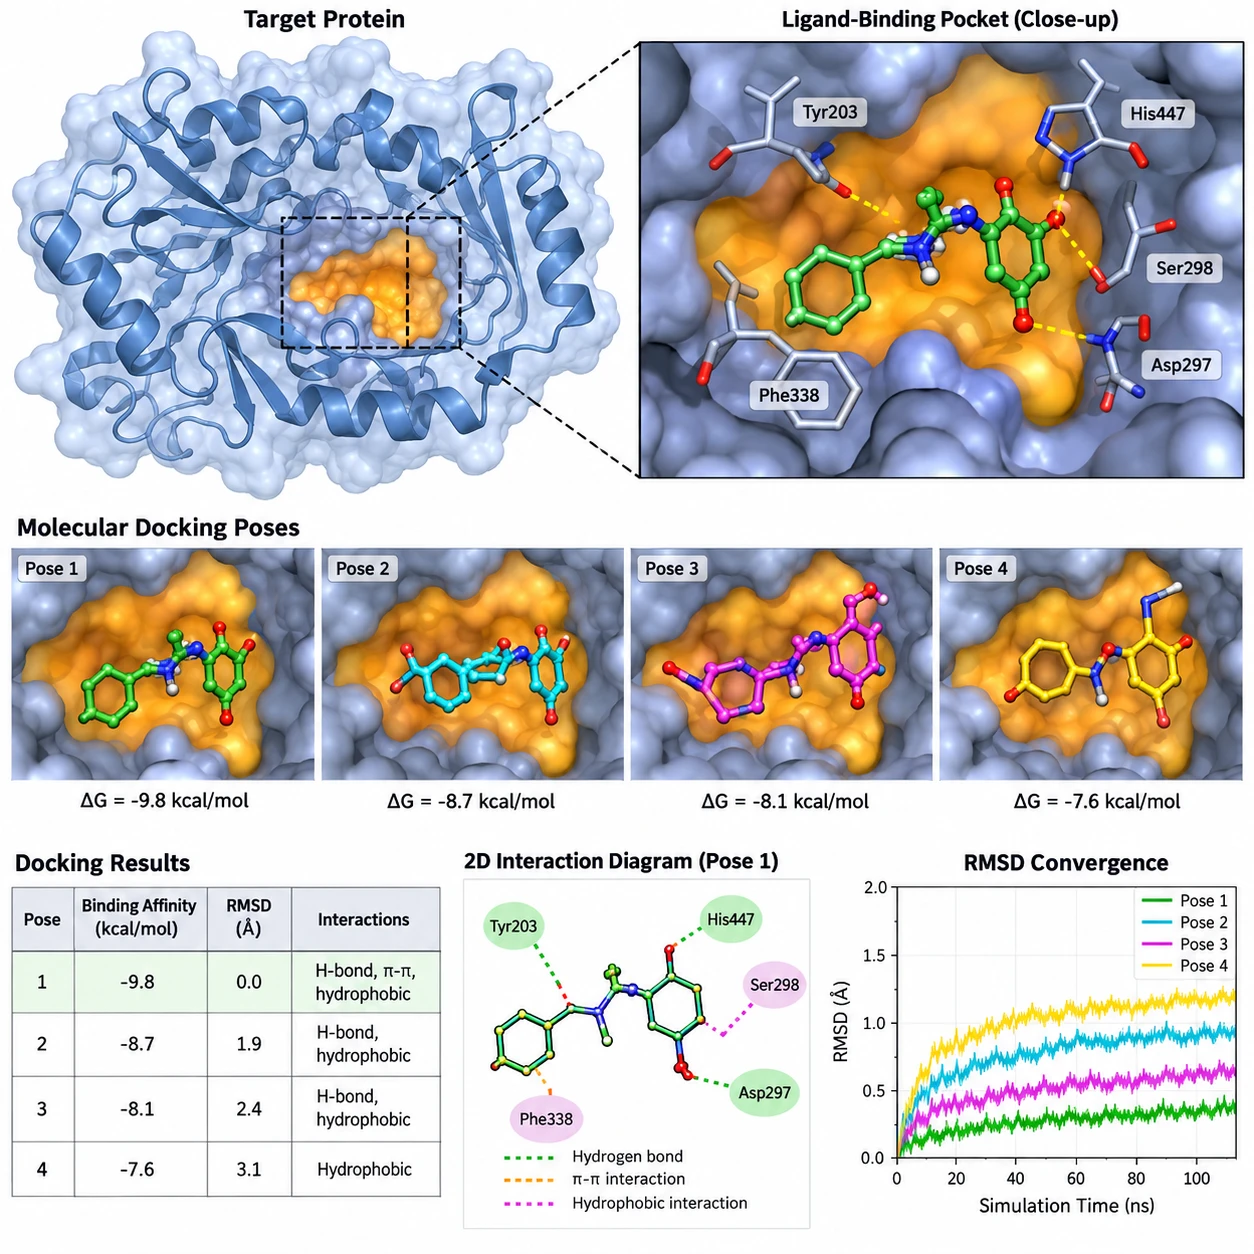
Najít místo, kde se léčivo může navázat na proteinový cíl, je jeden z prvních kroků při návrhu účinných molekul. Výpočetní metody pomáhají vyhledat pravděpodobné vazebné místo v trojrozměrné struktuře nebo proteinové sekvenci a určit, které oblasti stojí za další výzkum. Výsledek je třeba chápat jako testovatelnou hypotézu, nikoli jako potvrzení, že molekula bude fungovat jako léčivo.
Co je vazebné místo a proč ho předpovídat
Vazebné místo je oblast biologického cíle, nejčastěji proteinu, na kterou se může navázat ligand, například léčivá molekula. Jeho předpověď pomáhá zúžit hledání vhodných sloučenin a nasměrovat návrh i následné experimenty.
Vazbu ovlivňuje tvar a chemické vlastnosti povrchu proteinu: náboj, hydrofobicita, možnost vytvářet vodíkové vazby i prostorové uspořádání aminokyselin. Některá místa leží v dobře patrných dutinách, například v aktivním centru enzymu. Jiná jsou mělčí nebo se vytvoří až při pohybu proteinu. Vazebné místo navíc nemusí být totožné s funkčním místem, kde protein vykonává svou biologickou činnost. Molekula se může navázat i na jiné místo a ovlivnit funkci nepřímo.
Pro objevování léčiv je určení místa praktické: výzkumníci mohou zaměřit molekulární dokování na konkrétní oblast a ve virtuálním screeningu porovnávat velké knihovny sloučenin. Samotná predikce místa ale neurčuje, zda se ligand naváže silně, zda ovlivní biologickou aktivitu, ani zda bude bezpečný v organismu.
Jaká data metody potřebují
Metoda potřebuje data odpovídající otázce: strukturní přístupy vyžadují prostorový model proteinu, zatímco sekvenční modely mohou pracovat s pořadím aminokyselin. Kvalita vstupů a jejich biologická relevance často určují spolehlivost výsledku.
Experimentálně určená struktura z rentgenové krystalografie, kryoelektronové mikroskopie nebo NMR poskytuje přímý obraz proteinu, ale nemusí zachycovat všechny jeho stavy. Pokud struktura chybí, lze použít model získaný metodami predikce struktury proteinů. Takový model je užitečný pro tvorbu hypotéz, jeho lokální nepřesnosti však mohou změnit tvar či chemii předpokládané kapsy.
Dalším zdrojem jsou sekvenční data, známé ligandy a experimentálně popsané interakce. Homologní proteiny mohou napovědět, kde se vazebná oblast nachází, a databáze interakcí mohou dodat příklady pro strojové učení. Před analýzou je vhodné ověřit, zda model zahrnuje správnou izoformu, biologický řetězec a případné kofaktory. Chybějící části proteinu, nesprávně nastavený protonační stav nebo zanedbaný kovový ion mohou ovlivnit predikci i následné dokování.
Praktická kontrola vstupů se dá zjednodušit na tři otázky: Je biologický cíl správný? Je struktura dostatečně kvalitní v oblasti zájmu? Odpovídají známé ligandy zamýšlenému typu vazby? Pokud je odpověď nejistá, je lepší porovnat několik zdrojů než spoléhat na jediný model.
Strukturní metody predikce
Strukturní metody hledají vazebné místo přímo v prostorovém modelu proteinu. Analyzují jeho povrch, dutiny a chemické vlastnosti, případně zkoušejí, jak se do vybraných oblastí vejdou kandidátní ligandy.
Programy pro analýzu povrchu odhadují kapsy podle geometrie, hloubky, dostupnosti rozpouštědlu a rozmístění vhodných interakčních skupin. Výstupem bývá několik potenciálních míst se skóre nebo pořadím. Toto pořadí pomáhá při prioritizaci, ale nejde o pravděpodobnost klinického úspěchu; skóre závisí na algoritmu i kvalitě struktury.
Molekulární dokování umísťuje ligand do zvoleného místa a hledá příznivé orientace a konformace. Může pomoci porovnat kandidátní pózy nebo vysvětlit, které aminokyseliny by se mohly podílet na vazbě. Dokování obvykle předpokládá zjednodušený model proteinu a jeho skórovací funkce nezachycují všechny vlivy vody, entropie ani změn struktury. Proto je vhodné vyhodnocovat více póz a nevybírat sloučeninu jen podle jednoho čísla.
Molekulární dynamika simuluje pohyb atomů v čase a může odhalit, zda kapsa zůstává přístupná, mění tvar nebo přechodně vzniká. Pomáhá zkoumat flexibilitu proteinu a stabilitu navržené vazebné pózy, ale vyžaduje více výpočetního času a výsledek závisí na nastavení simulace. Často proto navazuje na rychlejší strukturní analýzu a dokování, místo aby je nahrazovala.
Metody založené na sekvenci a strojovém učení
Sekvenční metody a strojové učení odhadují vazebné oblasti z vlastností aminokyselin, podobnosti s jinými proteiny nebo příkladů známých interakcí. Mohou být užitečné i tehdy, když není k dispozici spolehlivá experimentální struktura.
Jednodušší modely využívají například konzervovanost sekvence, sousedství aminokyselin nebo známé motivy spojené s funkcí proteinu. Pokud se určitá oblast během evoluce mění pomalu, může to naznačovat důležitou roli, ale samo o sobě to nedokazuje, že právě tam váže léčivo. Podobnost s proteinem, jehož vazebné místo je známé, poskytuje vodítko; rozdíly v sekvenci či struktuře však mohou změnit chemii kapsy.
Hluboké učení dokáže kombinovat sekvenční, strukturní a ligandová data a zachytit složitější vzorce než ručně sestavená pravidla. Některé modely zpracovávají trojrozměrnou strukturu, jiné pracují s reprezentacemi proteinové sekvence a molekul. Jejich výkon závisí na tom, zda trénovací data odpovídají cílovému proteinu a úloze. Model může také příliš dobře rozpoznávat rodiny proteinů přítomné v trénovací sadě, ale hůře fungovat na nových cílech.
Při interpretaci je proto důležité zjistit, na jakých datech byl model trénován, co přesně předpovídá a jak se testoval. Predikce vazebného místa, klasifikace interakce a odhad vazebné afinity jsou odlišné úlohy. Jedno skóre nelze bez ověření přenášet mezi nimi.
Srovnání metod a jejich omezení
Žádná metoda není nejlepší pro všechny cíle: vhodný přístup závisí na dostupných strukturách, sekvencích a známých ligandech i na tom, zda je protein flexibilní. V praxi často funguje nejlépe kombinace metod s různými typy vstupů.
- Strukturní analýza: vhodná pro hledání dutin v kvalitním modelu; omezuje ji nepřesnost struktury a přehlédnutí přechodných kapes.
- Dokování: užitečné pro porovnání možných vazebných póz; výpočetně náročnější než samotná detekce kapes a citlivé na nastavení receptoru i skórovací funkci.
- Molekulární dynamika: přináší pohled na pohyblivost proteinu; vyžaduje více času a pečlivé nastavení simulace.
- Sekvenční a ML přístupy: mohou pracovat i bez hotové struktury; jejich spolehlivost závisí na kvalitě, rozsahu a nezávislosti trénovacích dat.
Častou chybou je považovat nejvyšší skóre za jistý nález. Skóre vyjadřuje výsledek konkrétního modelu, ne záruku biologického účinku. Pomáhá porovnávat kandidáty v rámci stejného postupu, ale jeho význam nelze automaticky srovnávat mezi různými programy.
Další úskalí představuje rigidní model proteinu. Pokud je vazebné místo pohyblivé, jediná struktura může ukazovat kapsu v nevhodném stavu. Pomoci může soubor struktur, modelování různých konformací nebo molekulární dynamika. Přidává to výpočetní náklady, ale může omezit falešné závěry založené na jediném statickém obrazu.
Ověření předpovědi a využití při objevování léčiv
Výpočetní předpověď se ověřuje tak, že se nezávisle testuje její biologický význam a interakce s ligandem. Ve vývoji léčiv slouží jako filtr a nástroj pro plánování experimentů, nikoli jako náhrada laboratorního měření.
Po výběru pravděpodobné oblasti může následovat virtuální screening, při němž se knihovna molekul hodnotí podle toho, zda se do místa vejdou a jaké interakce mohou vytvořit. Výzkumníci pak vyberou menší počet sloučenin pro laboratorní testy. Výsledky experimentů mohou ověřit vazbu, její sílu nebo změnu funkce cíle; každý test odpovídá na jinou otázku, proto je vhodné zvolit jej podle původní hypotézy.
Užitečné je plánovat ověření předem. Pokud model předpovídá konkrétní kontakty mezi ligandem a aminokyselinami, lze zvážit jejich cílenou změnu a sledovat, zda se vazba či aktivita změní. Takové výsledky mohou podpořit nebo zpochybnit navržený mechanismus. Ani potvrzená vazba sama o sobě neprokazuje účinnost či bezpečnost léčiva v organismu; k tomu jsou zapotřebí další výzkumné a klinické kroky.
Nejspolehlivější pracovní postup propojuje strukturní bioinformatiku, predikci struktury proteinů, dokování a podle potřeby molekulární dynamiku se strojovým učením a experimentální validací. Každá metoda odpovídá na trochu jinou část problému. Shoda nezávislých přístupů může zvýšit důvěru v hypotézu, zatímco neshoda upozorní na nejistotu, kterou je třeba prozkoumat.
Časté otázky
Jaký je rozdíl mezi predikcí vazebného místa a molekulárním dokováním?
Predikce vazebného místa hledá oblast proteinu, kde by ligand mohl interagovat. Molekulární dokování obvykle zkoumá, jak se konkrétní ligand do vybraného místa umístí a jaké pózy mohou být příznivé. Dokování tedy může předpokládat, že místo už bylo určeno, i když některé postupy hledají obojí současně.
Lze vazebné místo předpovědět bez známé struktury proteinu?
Ano, sekvenční metody a modely strojového učení mohou navrhnout pravděpodobnou oblast i bez experimentální struktury. Pomoci může také predikce struktury proteinů. Přesnost však závisí na kvalitě modelu a dostupných příbuzných datech, takže závěr vyžaduje opatrnost a ověření.
Proč se výpočetní předpovědi ověřují experimentálně?
Model zjednodušuje skutečné biologické prostředí a může přehlédnout vodu, pohyblivost proteinu, kofaktory nebo buněčné podmínky. Experimentální validace ověřuje, zda předpovězená vazba či funkční změna nastává v měřitelném systému.
Jak pohyblivost proteinu ovlivňuje výsledek?
Protein může měnit tvar a některé vazebné kapsy se otevírají jen v určitých konformacích. Analýza jediné struktury pak může místo přehlédnout nebo nadhodnotit jeho vhodnost. Pomáhá porovnat více struktur, zahrnout flexibilitu při dokování nebo použít molekulární dynamiku, která však vyžaduje více výpočetních zdrojů.